【2026年最新】AWSサポートとは?料金・プランの違いと選び方
AWSサポートとは?4つのプランの料金・対応範囲・応答時間の違いや、問い合わせ方法、選び方を解説。NTT東日本のAWS構築・運用支援も紹介します。
 |
こんにちは。エンジニアの森です。 |
|---|
2026年9月15日にTypeSafe AI(以下、TypeSafe)が、文章を生成せずに確率付きの判断を返す新しい種類のAIモデル「System Oneモデル」の第1弾としてJev(ジェブ)※を発表しました。
Jevの概要と実際に動作させた結果は、こちらのコラムでご紹介していますのでぜひご覧ください。
Jevの読み方は公式に記載がないため、本コラムでの読み方です。
Jevが登場してから約1か月の間に意思決定モデル(文章を生成せず、選択肢ごとの確率を返すモデル。以下、decision model。System Oneモデルは、この種のモデルに対するTypeSafeの呼び名)が相次いで登場しました。
10月1日にはCloudflareがJevのAPIと互換性のあるClefを同社のAI実行基盤であるWorkers AIで公開し、10月22日にはOpenAIがDecisions APIを一般提供しました。
オープンソースソフトウェア(OSS)でも、Standard ThinkingのStandard OneやAmazon Web Services(AWS)のStrands deciderが公開されています。
さらに私の周りでは「判定ならBERTでいいのでは」という声もありました。BERT(Bidirectional Encoder Representations from Transformers)は、文章の意味を読み取ることに特化した言語モデルで文章の分類に従来から使用されてきたものです。
選択できる手段がこれだけ増えれば、次に気になるのは「Jevは他と比較してどうなのか」です。
大規模言語モデル(LLM)で行っている判定をJevに置き換えたら何が変わるのか、decision modelやBERTと同じデータで比較したらどれが良いのかを知りたくなります。
しかも公式ドキュメントには、日本語など漢字を使用する言語は英語と同じ品質ではないため、自分のデータで確認するよう記載されています。
そこで本コラムでは、同じ日本語の問い合わせ文をJev・LLM・decision model・BERTに入力し、正答率・確信度(モデルが答えに付ける0〜1の確率。1.00が100%)の信頼性・応答時間・費用を徹底比較していきます。
本コラムの結果は、私が用意した評価データと条件での測定値です。データや条件が変われば、結果も変わる可能性があります。
NTT東日本では、AIやクラウドに関するお役立ち情報をメールマガジンにて発信していますので、ぜひこちらからご登録ください。
目次:
比較の基準はTypeSafeのJevです。同じ日本語の問い合わせ文をLLM、他社のdecision model、BERTにも入力し、4つの指標で比較しました。この章では、比較したモデルと評価データ、指標を説明します。
比較するモデルは以下の通りです。これまで判定によく使用していたLLM、Jevと同じく選択肢と判断基準を入力して確率付きで答えるdecision model、そしてBERTです。
| カテゴリー | モデル | 実行場所 |
|---|---|---|
| 比較の基準 | Jev(TypeSafe) | TypeSafeのAPI(国外) |
| LLM | Claude Sonnet 4.6(Anthropic) | Amazon Bedrock(東京リージョンで受け付け、世界のリージョンで推論するグローバル推論) |
| LLM | Amazon Nova 2 Lite(Amazon) | Amazon Bedrock(東京リージョンで受け付け、世界のリージョンで推論するグローバル推論) |
| decision model | Decisions API(OpenAI) | OpenAIのAPI |
| decision model | Clef・Clef-flash・Clef-omni(Cloudflare) | CloudflareのWorkers AI |
| decision model | Standard One 3B・8B(Standard Thinking、OSS) | AWS東京リージョンのEC2に構築したGPUサーバー |
| decision model | Strands decider(AWS、OSS) | AWS東京リージョンのEC2に構築したGPUサーバー |
| BERT | ModernBERT-Ja(以下、ModernBERT)のファインチューニング。正解付きのデータで追加学習する | 学習:NVIDIA DGX Spark、応答時間の計測:AWS東京リージョンのEC2に構築したGPUサーバー |
| BERT | ruri-v3の埋め込みとロジスティック回帰。文を数値のベクトルに変換し、選択肢を選択する分類器だけ学習する | 学習:NVIDIA DGX Spark、応答時間の計測:AWS東京リージョンのEC2に構築したGPUサーバー |
| BERT | 自然言語推論(NLI)によるゼロショット分類(mDeBERTa、日本語BERT)。追加学習せず、入力文と選択肢の文を意味で照合する | AWS東京リージョンのEC2に構築したGPUサーバー |
Jev以外のdecision modelは、いずれもLLMをベースにして文章を生成せずに選択肢の確率を出力する仕組みを追加したものです。
一方Jevは、公式が独自のアーキテクチャと学習方法で一から開発したと説明しており、成り立ちが違います。BERTは上記3つの手法で評価しました。
学習が必要な2つの手法は、品目名やFAQ(よくある質問)の文面と問い合わせ文の例を合計した14,320件で私が学習させました。
OSSのdecision modelは、重みが公開されているものの中から、「日本語に対応すると公式に明記している」「今回の選択肢の数(どれにも当たらない場合の「該当なし」を含めて最大209個)を入力できる」「商用利用できるライセンスである」の3つの条件で私が選定しました。
この条件を満たしたのはStandard Oneであり、3Bと8Bの2サイズを評価しました。Strands deciderは日本語の対応を明記しておらず入力の長さの既定値では全選択肢を入力できませんが、AWSが公開しているOSSなので私が入力の長さの上限を拡大して追加しました。
利用者の多いKevやMapikaのdeciderは対応言語が英語とだけ示されているため、Layaは選択肢が20個を超えると精度が低下すると公式に記載されているため、OpenJevは非商用のライセンスであるため除外しました。
Clefも重みが公開されていますが、この比較ではCloudflareのAPIとして扱います。
自治体に寄せられる問い合わせを想定し、「問い合わせ文を1つ入力し、あらかじめ用意した選択肢から答えを1つ選択させる」判定を2種類用意しました。
評価に使用した問い合わせ文は305件(ごみの品目135件、選挙の質問170件)です。
どの選択肢にも該当しない問い合わせ(ごみの品目32件、選挙の質問14件)は「該当なし」が正解です。同じ文を全モデルに入力し、答えが正解と一致するかを集計しました。
評価する指標は4つです。
評価データとは別に自治体の実際の問い合わせを元に作成した299件(以下、開発データ)も用意しました。
開発データはJevの質問の定義(選択肢とその説明)の調整、しきい値の決定、BERTの学習に使用しました。
評価データの305件は、定義を固定したあとに品目名とFAQの一覧をもとに新たに作成し、全件の正解を私が確認したものです。
NTT東日本では、AIやクラウドに関するお役立ち情報をメールマガジンにて発信していますので、ぜひこちらからご登録ください。
Jevは、正答率・確信度の信頼性・応答時間の3つでAPIの中で最上位でした。この章では、指標ごとの結果を順に示します。
ごみの品目ではJevとDecisions APIが99.3%で同率であり、選挙の質問ではJevとruri-v3が98.8%で最も高く、Claude Sonnet 4.6が97.6%で次点でした。
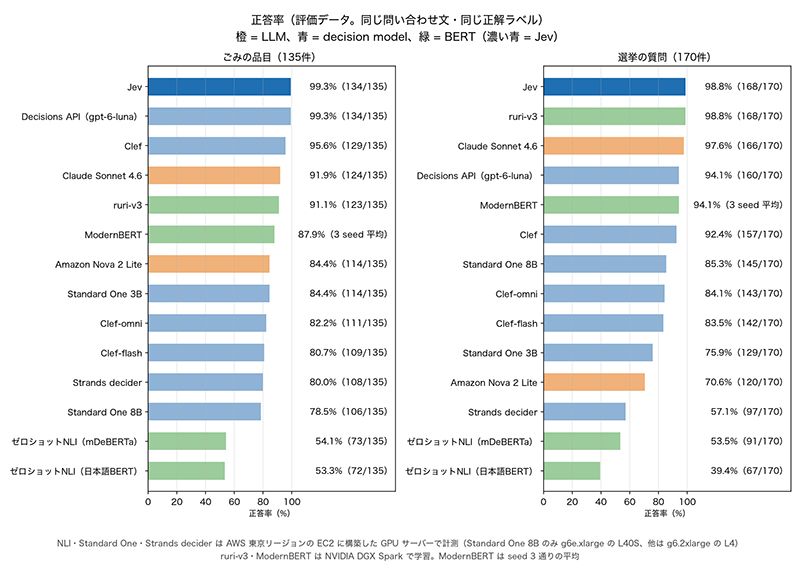
Nova 2 Liteは84.4%と70.6%にとどまり、AWS上に構築したStandard OneとStrands deciderは57.1〜85.3%でした。
学習させたBERTは、ごみの品目ではruri-v3が91.1%、ModernBERTが87.9%でJevに及びませんでした。学習しないゼロショットのNLIは39.4〜54.1%です。
問い合わせ文は全モデルに同じものを入力し、LLMとdecision modelには同じ質問の定義も入力しました。ModernBERTはseed(乱数の初期値)を変更した3回の平均で示しています。
確信度を返すモデルなら、確信度の高い判定はそのまま使用し、低い判定だけを人が確認する構成を採用することができます。
そこで各モデルの判定をそのモデル自身の確信度の高い順に並べ、上位8割を確認なしで使用するとしたらその中の正答率がいくつになるかを集計しました。
今回使用したLLMの呼び出しは答えだけを返し、選択肢ごとの確率を取得していないため、この比較には入れていません。
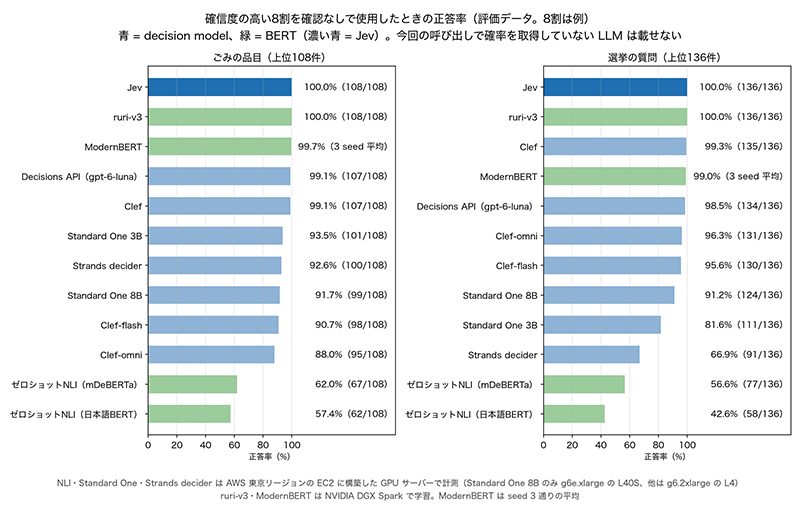
Jevは、2種類の判定のどちらも正答率100%でした。全体で3件あったJevの誤りは、すべて確信度の低い2割に含まれています。
ClefとDecisions APIも98.5〜99.3%であり、この3つのdecision modelは確信度を振り分けに使用できます。学習させたBERTも、ruri-v3は2種類とも100%、ModernBERTは99.7%と99.0%であり、確信度を振り分けに使用できます。
一方、Clef-flash・Clef-omni・Standard One・Strands deciderは上位8割でも66.9〜96.3%にとどまり、確信度が高くても確認を省略できません。ゼロショットのNLIは上位8割でも42.6〜62.0%が正解であり、確信度で限定しても確認なしでは使用できません。
上位8割は、ごみの品目では108件、選挙の質問では136件です。上位9割に限定してもJevの誤りは0件でした。
誤りの件数が少ないため、Jev・Clef・Decisions APIの差(0件と1〜2件)は有意な差ではありません。
確信度の値の分布はモデルごとに違い、平均はJevが0.92と0.94、Clefが0.50と0.61です。運用で値のしきい値を固定するときは、モデルを変更するたびに自分のデータで決定し直す必要があります。
Jevは、開発データで決定した値(ごみの品目0.87・選挙の質問0.80)を適用しても、確認なしで使用できる判定がごみの品目で84%、選挙の質問で91%あり、その中の誤りは0件でした。
応答時間は、日本国内にある私のPCから各モデルを呼び出し、1件の応答が返るまでの時間(通信時間を含む)で比較しました。APIは2件ずつ並行して、GPUサーバーは1件ずつ順に呼び出しました。
APIの中ではTypeSafeのJevが222〜227ミリ秒で最も速く、AWS上に構築したGPUサーバーで動作させたModernBERTとruri-v3は27〜30ミリ秒でJevより速く応答しました。
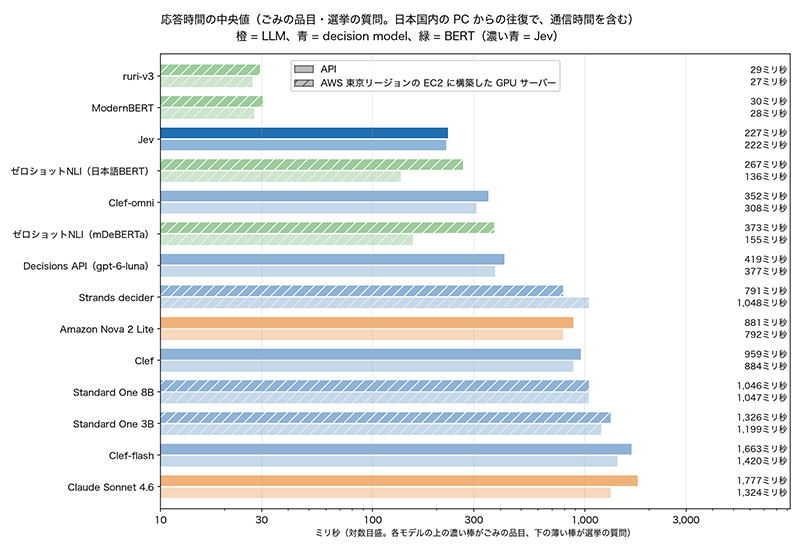
同じdecision modelでもClef-flashはJevの6〜8倍を要しました。Claude Sonnet 4.6も6〜8倍です。
AWS上に構築したStandard OneとStrands deciderは791〜1,326ミリ秒であり、Cloudflare Workers AIのClefと同じ水準でした。
同時に多くの判定を処理する場合、AWS上に構築したモデルは件数に応じてGPUサーバーを増設する必要がありますが、APIは提供元がサーバーを運用するため、利用者は各APIの上限の範囲内で並列に呼び出すことが可能です。
一方、今回のGPUサーバーは同時に届いた判定を1件ずつ順に処理する構成のため、同時に呼び出す件数が多いほど後の判定の待ち時間が増加し、学習させたBERTがJevより速いという差は少なくなっていきます。
Amazon Bedrockは、東京リージョンで受け付けたリクエストを世界のリージョンに振り分けて推論するグローバル推論(グローバルのクロスリージョン推論)で呼び出しました。
GPUサーバーはAWSの東京リージョンにあり、TypeSafeのAPIは国外にあります。応答時間はどちらも1件ごとの値です。
APIの費用はClef-flashに次いでJevが安く、1件約$0.00035でした。AWS上に構築したモデルの費用は、GPUサーバーの時間単価に1件の応答時間を乗じた値としました。
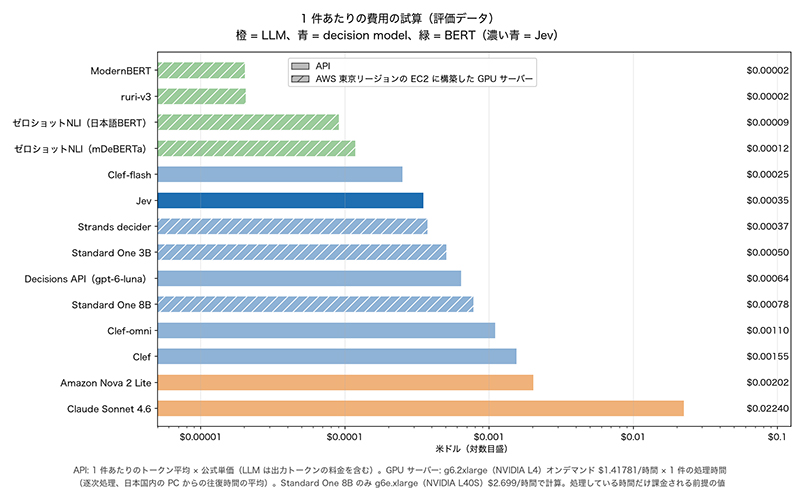
Decisions APIはJevの約2倍、Clef-omniは約3倍、Clefは約4.5倍、Nova 2 Liteは約6倍、Claude Sonnet 4.6は約64倍です。
Jevは判定のたびに質問の定義を送信するため入力トークンは多いのですが、入力の単価が低く出力が無料なので安くなります。
AWS上に構築したModernBERTとruri-v3は1件$0.00002でJevの約18分の1ですが、Standard OneとStrands deciderは$0.00037〜0.00078でJevより高くなりました。
ただしBERTなどのモデルをAWS上のGPUサーバーで運用する場合の費用は、判定の件数ではなくサーバーの稼働時間で決まります。
BERTを実行したg6.2xlargeを1か月稼働させ続けると約$1,035であり、Jevで同じ金額になるのは月約296万件です。月の件数がそれより少なければJevのAPIの方が安く、それを超える量を処理するならBERTをAWS上に構築する方が安くなります。
Standard OneとStrands deciderは、サーバーを常時稼働させて1件ずつ順に処理し続けても1件の費用がJevより高いため、件数を増加させてもJevより安くなりません。
2-1〜2-4のModernBERTとruri-v3は、品目名やFAQの文面と開発データの問い合わせ文を合計した898件にClaude Codeで作成した問い合わせ文の例13,422件を追加した14,320件で学習させたものです。
学習データが少ない場合(898件)と多い場合(14,320件)の違いは以下の通りです。正答率は評価データの305件全体の値です。
| モデル | 学習データの件数 | 正答率 | 確信度の高い8割の正答率 |
|---|---|---|---|
| Jev | 学習なし | 99.0% | 100% |
| ruri-v3 | 898件 | 75.1% | 79.1% |
| ruri-v3 | 14,320件 | 95.4% | 100% |
| ModernBERT | 898件 | 69.3% | 78.7% |
| ModernBERT | 14,320件 | 91.4% | 99.3% |
学習データを増加させると正答率と確信度の信頼性は大きく向上し、ruri-v3は確信度の高い8割の正答率がJevと同じ100%になりました。それでも正答率はJevの99.0%に及びません。
BERTの精度を向上させるには大量の学習データが必要であり、学習を短時間で完了させるにはGPUを搭載した環境も必要です。13,422件の例文はClaude Codeに作成させ、重複した文や評価データと酷似した文を除外して使用しました。
学習はNVIDIA DGX Spark 4台で並行して実行し、学習データの件数を898件から14,320件まで4通りに変更して比較した計16回が1時間53分で完了しました。私のPC(Apple M5を搭載したMac)では同じ16回に1日以上を要する見込みでした。
ModernBERTの1回の学習時間は、898件では6.3〜8.3分でしたが、14,320件では63.9〜80.7分と約10倍になり、1回の学習の費用は$0.15〜0.20から$1.51〜1.91に増加します。
さらにBERTは、選択肢を追加・変更するたびに例文の作成と学習を再実行する必要があります。Jevには学習の工程がなく、質問の定義を記述すればすぐに呼び出せます。
ModernBERTは3回の平均です。学習時間はDGX Sparkでの実測です。1回の学習の費用は、2-4のGPUサーバーで同じ時間を要したと仮定し、その単価($1.41781/時間)を乗じた試算です。
例文の作成では、Claude Codeに選択肢とその説明だけを入力し、評価データと開発データは入力していません。
NTT東日本では、AIやクラウドに関するお役立ち情報をメールマガジンにて発信していますので、ぜひこちらからご登録ください。
本コラムでは、同じ日本語の問い合わせ文をJev・LLM・decision model・BERTに入力し、正答率・確信度の信頼性・応答時間・費用を比較しました。
今回のデータでは、4つの指標を総合すると最もバランスが良かったのはJevでした。
どれを使用するのが良いかは以下の通りです。
なお今回の費用の比較はBERTをAWS上のGPUサーバーで運用する前提であり、オンプレミスのサーバーや自社で保有するPCなどGPUを搭載した環境がすでにある場合は、月の件数が少なくてもBERTを選択肢にできます。
今回のコラムが参考になれば幸いです。
今回比較したJevの概要と実際に動作させた結果はこちらのコラムでご紹介していますのでこちらもぜひご覧ください。本コラムに記載されてる会社名、サービス名、商品名は、各社の商標または登録商標です。
相談無料!プロが中立的にアドバイスいたします
クラウド・AWS・Azureでお困りの方はお気軽にご相談ください。