【2026年最新】AWSサポートとは?料金・プランの違いと選び方
AWSサポートとは?4つのプランの料金・対応範囲・応答時間の違いや、問い合わせ方法、選び方を解説。NTT東日本のAWS構築・運用支援も紹介します。
 |
こんにちは。エンジニアの森です。 |
|---|
2026年9月15日にTypeSafe AI(以下、TypeSafe)からSystem Oneモデルという新しい種類のAIモデルが発表され、ネット上ではかなり話題となりました。
文章を生成する大規模言語モデル(LLM)とは違い、システムの中で「どれに当てはまるか」「条件を満たすか」といった判断を担うためのモデルです。その第1弾がJev(ジェブ)※です。
Jevの読み方は公式に記載がないため、本コラムでの読み方です。
ただ、説明を読むだけでは、Jevが業務の中で何ができるのかは想像しにくいところです。
そこで本コラムでは、System Oneモデルとは何かを整理したうえでJevが業務の判断にどこまで使えるのか、実際に動かして確かめていきます。
JevとLLMや意思決定モデル(decision model)、BERTとの比較検証は、JevをLLMやdecision model、BERTと日本語データで徹底比較!!【TypeSafe Jev】にまとめていますのでこちらもぜひご覧ください。
NTT東日本では、AIやクラウドに関するお役立ち情報をメールマガジンにて発信していますので、ぜひこちらからご登録ください。
目次:
まずは、System Oneモデルがどのようなモデルなのかを公式の説明に沿って整理していきます。
System Oneモデルは、TypeSafeが2026年9月に発表した新しい種類のAIモデルです。
公式ドキュメントでは「ソフトウェアがそのまま使える、高速で構造化された判断を返すモデルの一群」と定義されています。Jevはその最初のモデルです。
同じ種類のモデルは他社からも出始めており、Cloudflareは10月1日にdecision modelのClefを公開し、10月19日には抽出モデル(extraction model)のClairicを公開しました。
Cloudflareはその発表でSystem Oneモデルを「選択肢から選んで確率を返すdecision model(JevとClef)」と「値を取り出す抽出モデル(Clairic)」に分けて説明しています。
この分け方はCloudflareの整理でTypeSafe公式の分類ではありませんが、「System Oneモデル」という言葉はTypeSafe以外にも広がりつつあります。
本コラムが扱うのは、TypeSafeのSystem Oneモデルの第1弾であるJevです。
問い合わせの振り分けを例にLLMに文章で答えさせる場合との違いを整理すると次のとおりです。
| 比べる点 | System Oneモデル | LLM(文章で答えさせる場合) |
|---|---|---|
| 入力 | 問い合わせ文と選択肢を定義した質問 | 問い合わせ文と回答の形式を指示するプロンプト |
| 出力 | 選ばれた選択肢と各選択肢の確率 | 生成された文章 |
| 出力をプログラムで扱う場合 | 出力の値をそのまま分岐に使える | 文章から答えを取り出し、指定した形式かどうかを検証する必要がある |
例えば、地方自治体にある清掃関連の問い合わせ窓口を想定し、「古い電気ポットはどの日に出せばいいですか。」という問い合わせを4つの窓口のどれに回すかをSystem Oneモデルに判断させる場合、入力と出力は次の図のとおりです。
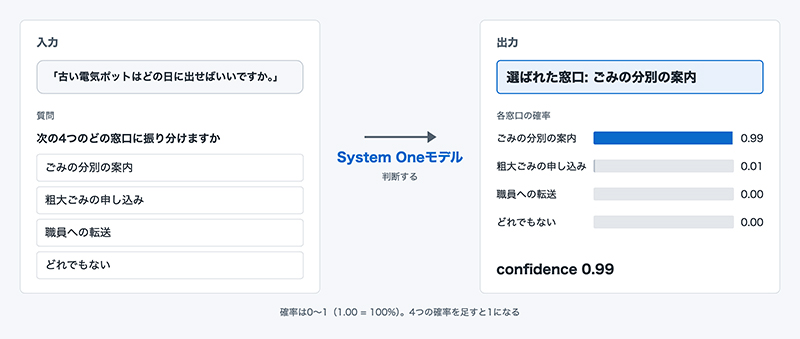
確率は0〜1の値です。1.00が100%を表し、すべての選択肢の確率を足すと1になります。この例では、ごみの分別の案内が0.99(99%)となり、ほぼ確実にこの窓口に当たるという判断です。
confidenceは、確率が1つの選択肢にどれだけ集中しているかを0〜1で表した値です。1つに集中するほど1に近づき、均等に割れるほど0に近づきます。
後段のプログラムは選ばれた窓口で処理を分け、confidenceが低いときだけ人が介入する、といった組み立てができます。実際のデータの形は、2章で解説します。
System Oneモデルへの質問は、出力の形式ごとに型が決まっています。公式はこの型をプリミティブと呼んでおり、Choice・Noul・Score・Boxの4つがあります。
このうちBoxは画像の中の位置を特定するプリミティブで画像入力とともに2026年10月時点では実験的な機能です。
| プリミティブ | 判定できること (清掃窓口での例) |
出力 |
|---|---|---|
| Choice (チョイス) |
定義した選択肢から1つを選ぶ(どの窓口に回すか) | 選ばれた選択肢、各選択肢の確率、confidence |
| Noul (ヌール)※ |
はい・いいえを判定する(職員と話したがっているか) | 「はい」である確率(0〜1) |
| Score (スコア) |
定義した段階のどれに当たるかを判定する(どのくらい急ぎか) | 段階の位置を表す値(score)、各段階の確率、confidence |
| Box (ボックス) |
画像の中の位置を特定する(写真のどこにアイロンがあるか) | 検出枠の位置(上下左右の端を画像の幅・高さに対する0〜1の比率で表した値)、confidence |
Noulの読み方は公式に記載がないため、本コラムでの読み方です。
呼び出しに使うAPIは1本だけです。POST https://api.typesafe.ai/v1/systemoneに判断の材料(state)と質問(questions)をJSONで入力します。
出力は、質問ごとの答え(answers)と使用トークン数(usage)です。1回のリクエストに異なるプリミティブの質問を複数入れることもできます(2-6で紹介します)。
具体的な呼び出し方は、公式のクイックスタートとプリミティブの説明をご確認ください。
NTT東日本では、AIやクラウドに関するお役立ち情報をメールマガジンにて発信していますので、ぜひこちらからご登録ください。
JevはTypeSafeのフラッグシップモデルです。
公式は、新しいモデルのアーキテクチャと並列サンプラー、RLCD(Reinforcement Learning for Calibrated Decisions)という学習方法で一から作ったと説明していますが、内部の構造やパラメータ数は公開されていません。
使い始める前に知っておきたい前提は、公式の記載をもとに次の表にまとめました。
| 項目 | 公式の記載 |
|---|---|
| バージョン | jev-1.13.0(別名jev-latest)とjev-1.14.0(別名jev-preview) |
| 料金 | 入力100万トークンあたり$0.042。出力は無料 |
| 言語 | 英語が中心。日本語も扱えるが、英語と同じ品質ではないため、自分のデータで確かめるよう案内している |
| データの扱い | 顧客のリクエストとレスポンスでは学習しない |
2026年11月時点
最新の料金と利用条件は、TypeSafeの公式ドキュメントをご確認ください。
ここからは、1-2で紹介した4つのプリミティブをJevで実際に動かしていきます。題材は、架空の自治体の清掃窓口への問い合わせです。
正解ラベルを付けていないため、精度の評価ではなく「この発話にこの確率が返った」という観測です。
まずは、Choiceで問い合わせを4つの窓口に振り分けます。stateに発話を入れ、選択肢の名前と説明はcriteriaに書きます。
{
  "model": "jev-1.13.0",
  "state": "古い電気ポットはどの日に出せばいいですか。",
  "questions": {
    "route": {
      "type": "choice",
      "instructions": "市の清掃窓口に寄せられた問い合わせを、次の 4 つのどれに振り分けますか。",
      "criteria": {
        "gomi_bunbetsu": "品物をどのごみ区分で、いつどのように出せばよいかを知りたい質問",
        "sodai_moshikomi": "粗大ごみの収集の申し込み、日時の変更、取り消しをしたい",
        "staff_tenso": "職員と直接話したい、または自動の案内では扱えない相談や苦情",
        "sonota": "上のどれにも当てはまらない"
      }
    }
  }
}
このリクエストに対する出力です。answersの中のrouteが質問への答えです。
choiceが選ばれた窓口、probabilitiesが各窓口の確率、usageが使ったトークン数です。1-1の図は、この出力を日本語にしたものです。
{
  "model": "jev-1.13.0",
  "answers": {
    "route": {
      "type": "choice",
      "choice": "gomi_bunbetsu",
      "confidence": 0.99,
      "probabilities": {"gomi_bunbetsu": 0.99, "sodai_moshikomi": 0.01, "staff_tenso": 0.0, "sonota": 0.0}
    }
  },
  "usage": {"input_tokens": 493, "output_tokens": 64}
}
発話を変えて入力した結果の一部です。表では、選択肢を「分別」「粗大」「職員」「他」と略しています。
| 発話(入力) | 選ばれた選択肢 | 確率 |
|---|---|---|
| ソファーの粗大ごみ収集を申し込みたいのですが。 | 粗大 | 粗大1.00 |
| 担当の方につないでもらえますか。 | 職員 | 職員1.00 |
| 住民票の写しを取りたいです。 | 他 | 他1.00 |
| 先週頼んだ収集の件で、ちょっと話したいんですが。 | 粗大 | 粗大0.56 / 職員0.41 |
| 収集に来なかったんですけど。 | 職員 | 職員0.40 / 粗大0.32 / 他0.26 |
振り分け先が明確な発話や、どの窓口にも当たらない発話には、1.00の確率が付きました。手続きの話にも職員と話したい気持ちにも読める発話では、確率が割れています。
確率が高いものは自動で案内し、割れたものだけ職員に回す、という使い方ができると考えています。
Noulは、「はい」か「いいえ」で答えられる問いに対して、「はい」である確率を0〜1の値で出力します。1に近いほど「はい」、0に近いほど「いいえ」です。0.5前後は「はい」と「いいえ」が同じくらいという意味です。
ここでは「大きさの情報があるか」「職員と話したいか」の2つを判定させました。Noulのリクエストは質問文(instructions)だけです。選択肢の定義はありません。
{
  "model": "jev-1.13.0",
  "state": "幅が180センチの本棚を出したいです。",
  "questions": {
    "has_size": {
      "type": "noul",
      "instructions": "発話に、品物の大きさや重さ(長さ・幅・高さ・重さなど)が分かる情報が含まれていますか。"
    }
  }
}
出力は、noulという1つの値だけです。この発話では0.97でした。
{
  "model": "jev-1.13.0",
  "answers": {"has_size": {"type": "noul", "noul": 0.97}},
  "usage": {"input_tokens": 328, "output_tokens": 21}
}
| 質問 | 発話(入力) | 出力(「はい」の確率) |
|---|---|---|
| 大きさの情報があるか | 幅が180センチの本棚を出したいです。 | 0.97 |
| 大きさの情報があるか | 古い本棚を出したいです。 | 0.04 |
| 職員と話したいか | 担当の方に代わってもらえますか。 | 0.87 |
| 職員と話したいか | 人と話したいんですが。 | 0.53 |
大きさの情報があるかは、幅を述べた発話が0.97、述べていない発話が0.04と明確に分かれました。一方、「人と話したいんですが。」は0.53でどちらとも言えない判断でした。
どの値から「はい」とみなすかは、使う側がしきい値で決めます。公式は、誤って「はい」と扱うと困る場合はしきい値を上げ、中間の値は人に回すといった使い方を案内しています。
Scoreは、あらかじめ定義した段階のどれに当たるかを判定します。今回は、問い合わせの急ぎ度合いを次の4段階で定義しました。
Scoreのリクエストでは、段階の説明をcriteriaに低い順に並べます。
{
  "model": "jev-1.13.0",
  "state": "来月の収集日をなんとなく知りたいと思って。",
  "questions": {
    "urgency": {
      "type": "score",
      "instructions": "この問い合わせは、どのくらい急ぎですか。",
      "criteria": [
        "急ぎではない。次の収集日までに分かればよい",
        "今週中に回答があれば困らない(例: 来週の収集に間に合わせたい)",
        "今日か明日中の対応が必要(例: 明日が引っ越しの退去日で、荷物を出せなくなる)",
        "今すぐ対応が必要(例: 危険物が出ていてけがや火災のおそれがある)"
      ]
    }
  }
}
出力は、各段階の確率(probabilities)と段階の位置を表すscore、confidenceです。legendには入力した段階の説明がそのまま返ります。
scoreは段階の番号に確率を掛けて足した値です。たとえば段階1と段階2が半々なら1.5というように段階の間の値にもなります。上の発話では段階0が0.97となり、scoreは0.03でした。
{
  "model": "jev-1.13.0",
  "answers": {
    "urgency": {
      "type": "score",
      "score": 0.03,
      "confidence": 0.97,
      "legend": {"0": "急ぎではない。次の収集日までに分かればよい", "1": "…", "2": "…", "3": "…"},
      "probabilities": {"0": 0.97, "1": 0.03, "2": 0.0, "3": 0.0}
    }
  },
  "usage": {"input_tokens": 462, "output_tokens": 18}
}
| 発話(入力) | 最も確率が高い段階 | その確率 |
|---|---|---|
| 明日の朝には部屋を引き渡さないといけなくて、まだ冷蔵庫が残っています。 | 段階2(今日か明日中) | 1.00 |
| ガスボンベが家の中で変な音を出して、シューシューと言っています。 | 段階3(今すぐ) | 1.00 |
| 来週のどこかで、粗大ごみを取りに来てもらいたいです。 | 段階1(今週中) | 0.51(段階0が0.49) |
冷蔵庫とガスボンベの発話には、状況に合った段階に1.00の確率が付きました。一方、「来週のどこかで」という発話は段階0と段階1に確率が割れ、scoreは0.51になりました。
4つ目のプリミティブであるBoxは、画像の中で探している物がどこにあるかを特定します。Boxを使うには画像の入力が必要です。
画像の入力は実験的な機能です。公式は本番利用の水準には達していないとして、試作や実験に使うよう案内しています。
使うには、リクエストに TypeSafe-Danger-Zone-Images: trueというヘッダーを付け、画像をassetsとして添えます。
画像の入力方法は、公式の画像入力の説明をご確認ください。
今回は、検証用に生成した画像22枚のうち6枚を入力し、モデルはBoxに必要なjev-1.14.0を使用しました。
Boxの出力は、対象を囲む検出枠の上下左右の端の位置です。
位置は画像の左上を起点とし、幅と高さに対する0〜1の比率で表します。たとえば左0.80・右0.99なら、検出枠は画像の幅の80%から99%の範囲にあります。
Boxは探した物が写っていなくても必ず検出枠を出力すると公式は説明しており、同じリクエストにNoulを入れて写っているかどうかも判定させるよう案内しています。
次のリクエストはその形です。アイロンと脚立のそれぞれについて、写っているか(Noul)と位置(Box)を判定させています。
{
  "model": "jev-1.14.0",
  "state": {"photo": "aff69eae-…-21"},
  "assets": {"aff69eae-…-21": {"type": "image", "part": "21_small-iron-lower-right"}},
  "questions": {
    "iron_visible": {"type": "noul", "instructions": "`photo` にアイロンが写っていますか。"},
    "iron_box": {"type": "box", "instructions": "`photo` の中のアイロン"},
    "stepladder_visible": {"type": "noul", "instructions": "`photo` に脚立が写っていますか。"},
    "stepladder_box": {"type": "box", "instructions": "`photo` の中の脚立"}
  }
}
出力は、Noulの値、Boxの検出枠(box)、そのconfidenceの3つです。Boxのconfidenceは、検出枠の確からしさを0〜1で表した値です。
高いほどモデルがその位置に自信を持っていることを示します。公式は推奨のしきい値を示しておらず、自分の画像で決めるよう案内しています。
この画像では、アイロンは写っている確率0.98で検出枠は右下(左0.80・上0.74・右0.99・下0.87)、confidenceは0.87でした。脚立は写っている確率0.03、confidenceは0.09でした。
{
  "model": "jev-1.14.0",
  "answers": {
    "iron_visible": {"type": "noul", "noul": 0.98},
    "iron_box": {"type": "box", "box": {"top": 0.74, "bottom": 0.87, "left": 0.8, "right": 0.99}, "confidence": 0.87},
    "stepladder_visible": {"type": "noul", "noul": 0.03},
    "stepladder_box": {"type": "box", "box": {"top": 0.22, "bottom": 0.7, "left": 0.07, "right": 0.44}, "confidence": 0.09}
  },
  "usage": {"input_tokens": 4438, "output_tokens": 78}
}
この出力を画像に重ねたものが次の図です。
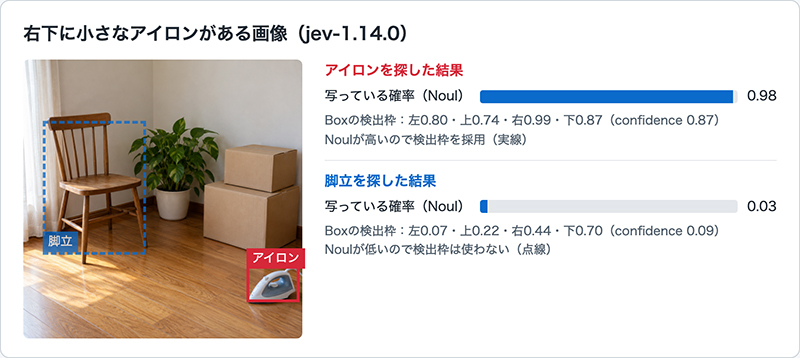
実線はNoulが0.5以上の対象、点線は0.5未満の対象です。
6枚とも、アイロンのNoulは0.96〜0.99で検出枠も目で見た位置と合い、写っていない脚立のNoulは0.02〜0.04でした。上の画像では脚立を探した枠が椅子の上に出ています。
Noulの値が低いときはBoxの結果を使わない、という組み合わせ方をすることで精度を保ちつつ、判別をすることが可能です。
2-1で使ったChoiceは、入力を文章から画像に変えれば写っている物を選択肢から選ばせることができます。
ここでは、14品目と「どれでもない」の15個の選択肢から写っている品目を選ばせました。リクエストはstateが画像になる以外は2-1と同じです。
{
  "model": "jev-1.13.0",
  "state": {"photo": "0882b269-…-15"},
  "assets": {"0882b269-…-15": {"type": "image", "format": "png", "data_base64": "(画像のbase64)"}},
  "questions": {
    "item": {
      "type": "choice",
      "instructions": "`photo` に写っている主な品物は、次のどれですか。",
      "criteria": {"アイロン": null, "傘": null, "フライパン": null, "…": null, "どれでもない": "上のどの品物でもない、または品物が写っていない"}
    }
  }
}
出力は2-1のChoiceと同じ形です。ダンボール箱の中にフライパンがある画像では、フライパンが0.83、ダンボールが0.17でした。
{
  "model": "jev-1.13.0",
  "answers": {
    "item": {"type": "choice", "choice": "フライパン", "confidence": 0.82, "probabilities": {"フライパン": 0.83, "ダンボール": 0.17, "アイロン": 0.0, "…": 0.0}}
  },
  "usage": {"input_tokens": 4855, "output_tokens": 298}
}
1つの品目だけがはっきり写った14枚では、すべて想定した品目に最も高い確率が付きました。何も写っていない画像では「どれでもない」が選ばれています。
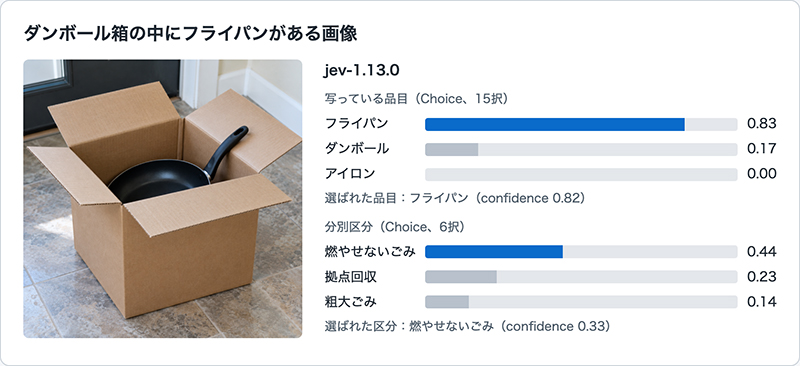
同じ画像に分別区分(燃えるごみ・粗大ごみなど、どの区分で出すか)も判定させたところ、架空の自治体の区分と一致したのは14枚中7枚でした。
分別のルールを入力せずに区分の名前だけで判定させているため、一致しないのは想定の範囲です。
品目は画像で判定し、どの区分で出すかは自治体のルールの表から引く、という役割分担が向いていると考えています。
最後にここまで1つずつ使ってきたプリミティブを1回のリクエストにまとめて入れます。
「タンスを捨てたいのですが、幅が120センチくらいあります。来週引っ越しなので急いでいます。」という発話に振り分け(Choice)、大きさの情報があるか(Noul)、職員と話したいか(Noul)、急ぎ度合い(Score)の4つの質問を同時に入れました。
リクエストは、questionsの中に2-1〜2-3の質問をそのまま並べるだけです。
{
  "model": "jev-1.13.0",
  "state": "タンスを捨てたいのですが、幅が120センチくらいあります。来週引っ越しなので急いでいます。",
  "questions": {
    "route": {"type": "choice", "instructions": "市の清掃窓口に寄せられた問い合わせを、次の 4 つのどれに振り分けますか。", "criteria": {"…": "2-1と同じ"}},
    "has_size": {"type": "noul", "instructions": "発話に、品物の大きさや重さ(長さ・幅・高さ・重さなど)が分かる情報が含まれていますか。"},
    "wants_staff": {"type": "noul", "instructions": "発話した人は、自動の案内ではなく職員と話すことを望んでいますか。"},
    "urgency": {"type": "score", "instructions": "この問い合わせは、どのくらい急ぎですか。", "criteria": ["…", "2-3と同じ"]}
  }
}
出力のanswersには、4つの質問の答えがそれぞれの形で並びます。
{
  "model": "jev-1.13.0",
  "answers": {
    "route": {"type": "choice", "choice": "sodai_moshikomi", "confidence": 0.41, "probabilities": {"gomi_bunbetsu": 0.42, "sodai_moshikomi": 0.56, "staff_tenso": 0.01, "sonota": 0.01}},
    "has_size": {"type": "noul", "noul": 0.98},
    "wants_staff": {"type": "noul", "noul": 0.33},
    "urgency": {"type": "score", "score": 1.0, "confidence": 0.94, "legend": {"…": "…"}, "probabilities": {"0": 0.03, "1": 0.94, "2": 0.03, "3": 0.0}}
  },
  "usage": {"input_tokens": 789, "output_tokens": 115}
}
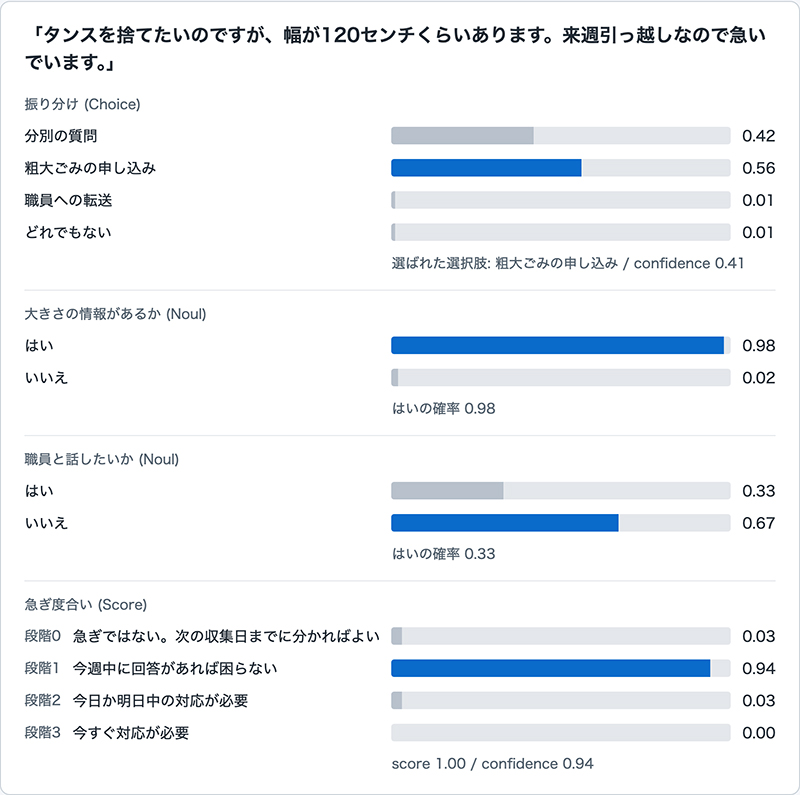
1回の呼び出しでどの窓口に回すか、必要な情報がそろっているか、どのくらい急ぐかをまとめて判定できました。
質問を増やしても応答時間が変わらないことは、3-1で示します。
NTT東日本では、AIやクラウドに関するお役立ち情報をメールマガジンにて発信していますので、ぜひこちらからご登録ください。
この章では、Jevを業務に使うときに気になる応答時間・費用・正答率を実測から示します。
応答時間は、2章の実行に加えて、検証用の発話739件(2章と同じ架空の自治体の題材)とAmazon Connectで構築した音声ボットで計測しました。
Amazon Connectは、AWSクラウド型コンタクトセンターサービスでAmazon LexやAWS Lambda、Amazon Bedrock(生成AI)と組み合わせると電話を自動で聞き取って応答するAI-IVRを構築できます。
今回の検証は、そうしたAI-IVRで通話の内容から「氏名を述べたか」「要件を述べたか」などを判定し、次に何を聞くかを決める部分をJevに任せたものです。
このAI-IVRは、通話の聞き取り結果をもとに次に何をするか(氏名を聞き直す、要件に進む、担当者に代わる、など)を判定しながら進みます。
| 実測 | 応答時間の中央値 / p95 |
|---|---|
| 2章の発話の判定(74件、手元のPCから) | 206 / 289ミリ秒 |
| 2章の画像の判定(129件、手元のPCから) | 392ミリ秒(中央値) |
| 検証用の発話739件(手元のPCから) | 232 / 310ミリ秒 |
| AI-IVRの判定489件(AWS Lambdaから) | 223 / 359ミリ秒 |
p95は、全体の95%の判定がその時間以内に収まる値です。手元のPCからの値は通信時間を含む参考値です。AI-IVRでは、こちら側で設定した800ミリ秒のタイムアウトを超えた2件を除いて集計しています。
JevのAPIは国外にあるため海外との通信を含みますが、文章の判定は200ミリ秒台で返りました。AI-IVRのように応答の速さが求められる場面でも、判定を待ってからそのまま応答する構成が取れる速さです。
公式は、1リクエストに入れた質問をすべて並列に評価するため、質問を増やしても応答時間は変わらないと説明しています。739件を1リクエストの質問数ごとに集計した結果です。
| 1リクエストの質問数 | 件数 | 応答時間の中央値 / p95 |
|---|---|---|
| 1問 | 320件 | 191 / 250ミリ秒 |
| 3問 | 208件 | 228 / 280ミリ秒 |
| 5問 | 20件 | 194 / 226ミリ秒 |
| 8問 | 133件 | 232 / 310ミリ秒 |
表にない2問・4問・6問・7問の58件は、中央値195〜218ミリ秒でした。8問の133件は、選択肢が209個あるごみの品目の判定です。質問数以外の条件は同じではありません。
1問から8問までの中央値は191〜232ミリ秒の範囲に収まりました。公式は、必要になるかもしれない質問も最初から全部入れておき、使うかどうかはコードで決める使い方を勧めています。
費用は入力トークン数で決まります(入力100万トークンあたり$0.042、出力は無料。トークンは文章を区切った単位です)。
判定のたびに発話と質問の定義(選択肢とその説明)を送るため、選択肢が多いほど1リクエストの入力トークンは増えます。
| 実測 | 入力トークンの合計 | 費用(試算) | 1リクエストあたりの平均 |
|---|---|---|---|
| 2章の発話の判定(74件) | 49,438 | 約$0.002 | 約$0.00003 |
| 2章の画像の判定(129件) | 633,692 | 約$0.027 | 約$0.0002 |
| 検証用の発話739件 | 3,317,804 | 約$0.14 | 約$0.0002 |
| AI-IVRの判定489件 | 1,443,815 | 約$0.06 | 約$0.0001 |
2026年11月時点
費用は、応答に含まれる入力トークン数に公式単価を掛けた試算であり、請求額の実測ではありません。最新の料金は公式ドキュメントをご確認ください。
選択肢が209個ある場面でも、1リクエストの入力は最大9,409トークンで約$0.0004でした。
正答率は、3-1でも使った検証用の発話739件で示します。発話ごとに期待する答えを付けてあり、ここでは件数がそろう次の2つの判定の結果を示します。
正答率は、最も確率が高い選択肢が期待する答えと一致した割合です。
| 判定 | 正答率 |
|---|---|
| ごみの品目の判定(133件) | 95.5%(127/133) |
| 選挙の質問の判定(166件) | 95.8%(159/166) |
どちらも9割を超えました。選択肢が209個あるごみの品目の判定でも、学習なしでこの正答率でした。
比較記事では、別に新たに作成した問い合わせ文305件で正答率を測定しており、Jevはごみの品目で99.3%、選挙の質問で98.8%でした。
NTT東日本では、AIやクラウドに関するお役立ち情報をメールマガジンにて発信していますので、ぜひこちらからご登録ください。
2章と3章の結果をもとにJevがどのような業務の判断に使えるかを整理しました。
| 業務の場面 | Jevに置き換える作業 | 使用するプリミティブ | 期待できる改善 |
|---|---|---|---|
| 問い合わせ窓口の振り分け | 職員が内容を聞いて窓口を決める | 窓口の選択(Choice)、職員と話したいか(Noul) | 確率の高いものは自動で案内し、割れたものだけ人に回せる |
| AI-IVRの次の行動の判定 | LLMに任せていた判定 | 「氏名を述べたか」などの判定(Noul) | 1リクエスト200ミリ秒台で判定でき、判定を待ってから応答できる |
| 対応順の並べ替え | 職員が内容を読んで急ぎかを判断する | 急ぎ度合い(Score) | 急ぐ問い合わせから対応できる |
| 申し込み写真の確認 | 職員が写真を見て品目を確かめる | 品目(Choice)と位置(Box) | 品目の確認を自動化できる見込み |
このように業務で使うさまざまな場面で行う幅広い判定にJevを活用することができると考えられます。
一方、向かない処理もあります。
また、Jevの出力は入力した選択肢の中から選ばれますが、選び間違えることはあると公式は説明しています。
日本語の品質も英語と同じではないとされているため、日本語で高い精度が必要な業務に使う場合は、自身のデータで評価してから任せるのがよいと考えています。
NTT東日本では、AIやクラウドに関するお役立ち情報をメールマガジンにて発信していますので、ぜひこちらからご登録ください。
本コラムでは、日本語の問い合わせ振り分けと画像の判定でJevを動かしてみました。
Jevは文章ではなく、確率付きの判断を出力しました。Choiceではどの選択肢に当たるか、Noulでは条件を満たすか、Scoreではどの段階に当たるかの確率です。
確率が1.00に寄る発話もあれば割れる発話もあり、割れたものだけ人に回すような使い方ができます。
文章の応答時間は1リクエスト200ミリ秒台で質問を8問に増やしても大きく変わりませんでした。費用は1リクエストあたり平均$0.00003〜0.0002(選択肢が209個ある判定でも最大約$0.0004)でした。
検証用の発話では、ごみの品目の判定で正答率95.5%、選挙の質問の判定で95.8%でした。
画像入力とBoxでは品目の判定と位置の特定ができましたが、まだ実験的な機能ですのでまずは試作で試すのがよいでしょう。
Jevは、新しいAIモデルといってもLLMのようにJevだけで何か役にたつものではありません。
しかし、さまざまなアプリやシステムに組み込むことで今回ご紹介したユースケース以外にも多くの業務に役にたつものになると強く感じています。
ぜひ、皆さんのユースケースで試してみてください。
今回のコラムが参考になれば幸いです。
今回ご紹介したJevをLLMやdecision model、BERTと比べたコラムもぜひご覧ください。
本コラムに記載されてる会社名、サービス名、商品名は、各社の商標または登録商標です。
相談無料!プロが中立的にアドバイスいたします
クラウド・AWS・Azureでお困りの方はお気軽にご相談ください。