【2026年最新】AWSサポートとは?料金・プランの違いと選び方
AWSサポートとは?4つのプランの料金・対応範囲・応答時間の違いや、問い合わせ方法、選び方を解説。NTT東日本のAWS構築・運用支援も紹介します。
「クラウド移行は済んだ」
「データもAmazon S3に保存している」
「でも、実際にはほとんど見返していない」
Amazon S3を導入したものの、十分に活用できず、このような状態になっていないでしょうか。
Amazon S3(Amazon Simple Storage Service)は、AWSが提供する代表的なクラウドストレージサービスです。バックアップやログ保管、ファイル保存の用途で使われることが多い一方で、S3の価値は「データを置けること」だけではありません。
Amazon S3活用とは、S3の機能を使いこなすことではなく、S3に眠るデータを業務判断・施策・改善に変えることです。
企業や自治体には、日々多くのデータが蓄積されています。販売データ、顧客データ、問い合わせ履歴、システムログ、画像、文書、センサーデータなどです。これらを保管するだけでは、保管コストが発生する一方で、業務への活用余地が残ったままになることがあります。
一方で、分析・可視化・予測・施策改善につなげれば、業務改善や意思決定に役立つ資産へと変わります。
本コラムでは、Amazon S3の基本を簡潔に整理したうえで、中堅企業・自治体の情報システム担当者に向けて、S3を「データ活用基盤」として使う方法を解説します。専門的なコードの説明には踏み込みすぎず、まず何から始めればよいかがわかる構成にしています。
目次:
Amazon S3の基本的な説明は検索すれば多く出てきます。そのため本コラムでは、S3活用を考えるうえで情報システム部門が押さえておきたいポイントに絞って説明します。
普段、パソコンや社内ファイルサーバーで使っている保存方式は、多くの場合「ファイルストレージ」です。フォルダを作り、その中にファイルを保存する方式です。
一方、S3が採用しているのは「オブジェクトストレージ」という方式です。S3ではデータを『オブジェクト』として保存し、オブジェクトキーで識別します。また、作成日時やContent-Typeなどのメタデータ、オブジェクトタグなどを用いてデータを管理できます。
イメージとしては、ファイルストレージが「人が見て探しやすい整理棚」だとすれば、オブジェクトストレージは「ラベル付きで大量保管できるデータ倉庫」です。大量のデータを保存し、必要に応じて検索・分析・システム連携しやすい点が特徴です。
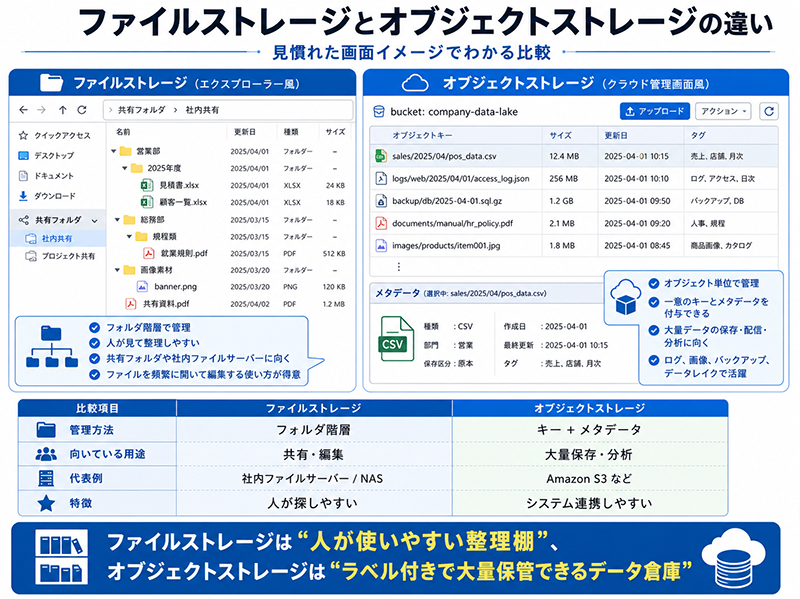
| 比較項目 | ファイルストレージ | オブジェクトストレージ(S3) |
|---|---|---|
| 管理方法 | フォルダ階層 | キー+メタデータ |
| 向いている用途 | 共有・編集 | 大量保存・分析 |
| 代表例 | 社内ファイルサーバー、NAS | Amazon S3など |
| 特徴 | 人が探しやすい | システム連携しやすい |
S3は、社内ファイルサーバーと同じ感覚で使うというより、大量のデータを保管し、後から分析や連携に使いやすくするための基盤と考えると理解しやすくなります。
S3でよく使われる「イレブンナイン」とは、S3 Standardが設計上目標とする99.999999999%のデータ耐久性を指します。
ここで注意したいのは、イレブンナインは「可用性」ではなく「耐久性」だという点です。
耐久性とは、保存したデータが失われにくいことです。
可用性とは、必要なときにサービスへアクセスできることです。
S3 Standardは、設計上99.999999999%のデータ耐久性を備えています。一方、可用性は設計上99.99%です。99.99%の可用性は、単純計算では年間約52.6分の利用不可時間に相当します。
つまり、S3は「保存したデータを失いにくく、必要なときに利用しやすい」クラウドストレージとして設計されています。
S3は、一般的に以下のような用途で使われます。
| 用途 | 具体例 |
|---|---|
| バックアップ | サーバー、DB、業務ファイルのバックアップ |
| ログ保管 | Webアクセスログ、アプリログ、監査ログ |
| 静的コンテンツ配信 | 画像、動画、HTMLなどの保管 |
| データレイク | 部門横断データの一元保管 |
| 分析基盤 | AthenaやRedshiftと連携したデータ分析 |
| AI・機械学習 | 学習データ、画像、文書、問い合わせ履歴の保管 |
この記事で重視するのは、S3をバックアップやログ保管に使うだけでなく、S3に保存されたデータを分析・可視化・業務改善に活かす方法です。
S3を導入していても、十分に活用できていない組織には共通点があります。
「データは貯めているが、活用できていない」状態です。これは、ツールの問題だけではなく、データの管理方法や業務部門との関わり方に原因があることも少なくありません。
| よくある状態 | 起きている問題 |
|---|---|
| とりあえずS3にデータを置いている | 目的がなく、活用につながらない |
| どのバケットに何があるか担当者しか知らない | データの所在が属人化している |
| ログやCSVを保管しているが分析していない | 改善につながる示唆を得られていない |
| 部門ごとにデータが分かれている | 顧客や業務を横断的に把握できない |
| データ形式がバラバラ | 分析や連携のたびに加工が必要になる |
| BIやAIと連携していない | データを意思決定に使えていない |
特に注意したいのは、データを貯めること自体が目的になってしまうことです。データは蓄積するだけでは、業務改善や意思決定といった価値につながりにくい場合があります。 売上分析、需要予測、問い合わせ削減、住民サービス改善など、具体的な目的に結びついて初めて意味を持ちます。
まずは、S3に保存されているデータを棚卸しすることから始めましょう。確認すべき観点は次のとおりです。
ここまで整理できると、S3を「保管場所」から「活用基盤」へ変える準備が整います。
「Amazon S3の中身が整理されていない」「部門ごとにデータが分散している」など、NTT東日本にご相談ください。データ棚卸しの整理からご支援します。
S3を単なるバックアップ先から「データ活用の起点」に変えるうえで重要なのが、データレイクやCDPという考え方です。
データレイクとは、構造化データ・非構造化データを問わず、さまざまなデータを一元的に蓄積する基盤です。
構造化データとは、販売実績や顧客マスタのように、表形式で整理しやすいデータです。
非構造化データとは、PDF、画像、音声、動画、問い合わせ文章、議事録など、表形式では扱いにくいデータです。
S3は、このような多様なデータをまとめて保管できるため、データレイクの保存基盤としてよく利用されます。
CDP(Customer Data Platform)は、顧客に関するデータを一元管理し、マーケティング、営業、カスタマーサポートなどに活用するための基盤です。
たとえば、Webサイト・アプリ・店舗・コールセンター・EC・会員情報など、複数の接点から集まるデータを統合することで、一人ひとりの顧客像を把握しやすくなります。
S3に購買履歴、行動履歴、問い合わせ履歴、会員データを集約することで、次のような施策につなげられます。
ただし、重要なのは、S3にデータを集めるだけで満足しないことです。S3に集めたデータを、分析、可視化、施策実行、効果検証につなげることで、初めてビジネス価値が生まれます。
| 対象 | S3に集約するデータ | 活用例 |
|---|---|---|
| 小売・EC | POS、ECログ、在庫、顧客データ | 需要予測、LTV分析、欠品防止 |
| 製造業 | 設備ログ、検査画像、センサーデータ | 異常検知、予知保全、品質改善 |
| 情報システム部門 | 問い合わせ履歴、FAQ、操作マニュアル | FAQ改善、社内ナレッジ検索 |
| 自治体 | 窓口データ、施設予約、申請データ | 混雑予測、住民サービス改善 |
データサイエンスというと難しく聞こえるかもしれませんが、最初から高度なAIを作る必要はありません。まずは、S3にあるデータから業務上の問いに答えることから始めます。
「どの商品が伸びているのか」
「どの時間帯に問い合わせが多いのか」
「どの顧客が離脱しやすいのか」
「どの設備で異常が起きやすいのか」
「どの窓口や手続きに負荷が集中しているのか」
こうした問いを業務部門と一緒に立てることが、S3活用の第一歩です。
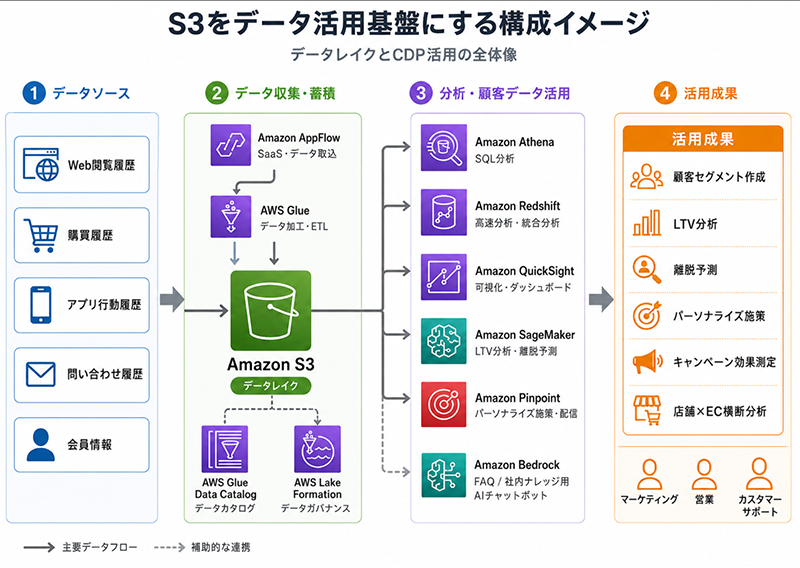
S3単体では「保存場所」ですが、他のAWSサービスと組み合わせることで、データ活用基盤へと変わります。
| サービス | 役割 | S3活用での使い方 |
|---|---|---|
| AWS Glue | データ加工・カタログ管理 | S3上のデータを整形し、分析しやすくする |
| Amazon Athena | SQL分析 | S3上のデータにSQLで直接問い合わせる |
| Amazon Redshift | データウェアハウス | 大規模なデータを集計・分析する |
| Amazon Quick Sight | BI・可視化 | ダッシュボードやレポートを作成する |
| Amazon SageMaker | 機械学習 | S3のデータを使って予測モデルを作る |
| Amazon Bedrock | 生成AI | S3の文書データを活用したAIチャットボットなどに使う |
| AWS Lake Formation | データガバナンス | データレイクの権限管理を行う |
たとえば、S3にCSVやログデータが保存されている場合、Amazon Athenaを使えばサーバーを用意せずにSQLで分析できます。AWS GlueでデータをParquet形式などに変換しておけば、分析コストや処理時間を抑えやすくなります。 Amazon Quick Sight で結果をダッシュボード化すれば、経営層や現場部門への共有もしやすくなります。
また、S3に社内文書、FAQ、マニュアルが蓄積されている場合、Amazon Bedrockと組み合わせることで、社内情報を参照するAIチャットボットの構築にも展開できます。ただし、AIは「データが整備されてこそ活きるもの」です。まずはデータの所在、形式、権限、更新ルールを整備することが先決です。
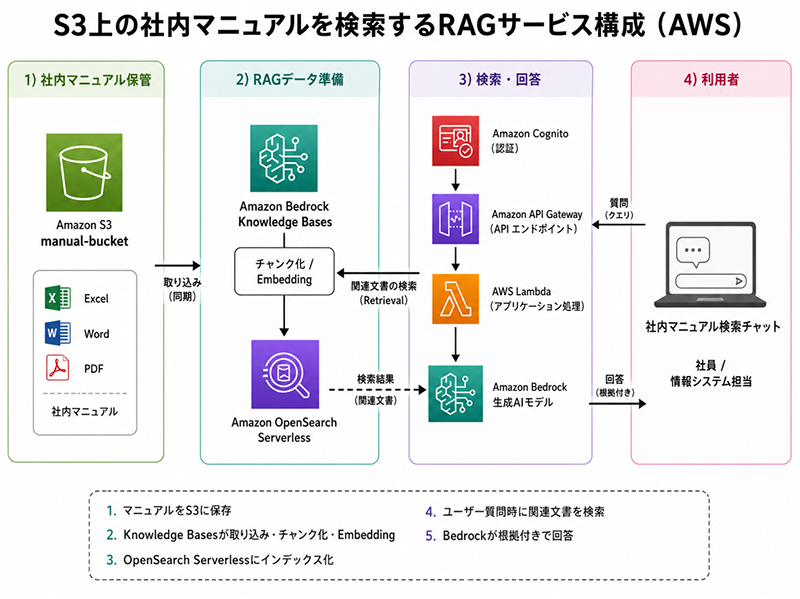
分散したEecel Word PDFなどのファイルを社内マニュアルの為にAIチャットボットにしている例
ポイントは、最初から多くのサービスを使おうとしないことです。S3+Athenaで小さく分析を始め、必要に応じてGlue、QuickSight、Redshift、SageMakerへ広げていく流れが現実的です。
「どのサービスをどう組み合わせればよいかわからない」という方へ、NTT東日本がデータ量や目的に合った構成をご提案します。
S3活用は、分析レポートを作って終わりではありません。分析結果を業務に反映し、改善を続けることがゴールです。
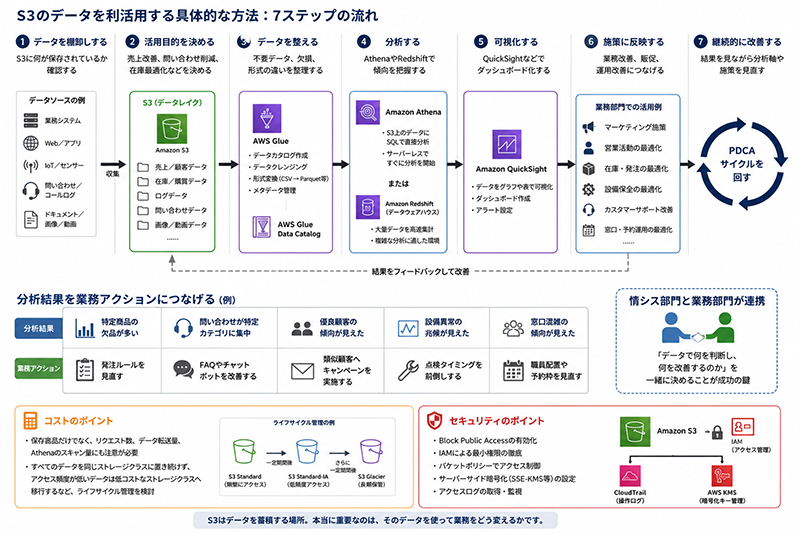
下図は、データの棚卸しから継続的な改善まで、S3データ利活用の流れを7ステップで整理したものです。
| ステップ | 内容 |
|---|---|
| 1. データを棚卸しする | S3に何が保存されているかを確認する |
| 2. 活用目的を決める | 売上改善、問い合わせ対応負荷の軽減 、在庫管理の改善など、取り組む業務課題を決める |
| 3. データを整える | 欠損、形式の違い、不要データを整理する |
| 4. 分析する | AthenaやRedshiftで傾向を把握する |
| 5. 可視化する | QuickSightでダッシュボード化する |
| 6. 施策に反映する | 業務改善、販促、運用改善につなげる |
| 7. 継続的に改善する | 結果を見ながら分析軸や施策を見直す |
大切なのは、分析結果を「業務アクション」まで設計することです。分析して終わりにせず、現場の行動が変わるところまで落とし込みます。
| 分析結果 | 業務アクション |
|---|---|
| 特定商品の欠品が多い | 発注ルールを見直す |
| 問い合わせが特定カテゴリに集中 | FAQやチャットボットを改善する |
| 優良顧客の傾向が見えた | 類似顧客へキャンペーンを実施する |
| 設備異常の兆候が見えた | 点検タイミングを前倒しする |
| 窓口混雑の傾向が見えた | 職員配置や予約枠を見直す |
データ活用を進めるうえでは、技術面だけでなく、分析結果を実際の意思決定や業務改善につなげる体制づくりも重要です。 情報システム部門と業務部門が、「データで何を判断し、何を改善するのか」を一緒に決めていくことが成功の鍵になります。
S3活用では、分析方法だけでなく、コストと情報セキュリティの設計も重要です。
コスト面では、保存容量だけでなく、リクエスト数、データ転送量、Athenaのスキャン量にも注意が必要です。すべてのデータを同じストレージクラスに置き続けるのではなく、アクセス頻度が低いデータは低コストなストレージクラスへ移行するなど、ライフサイクル管理を検討しましょう。
セキュリティ面では、Block Public Access、IAM、バケットポリシー、暗号化、アクセスログの確認が重要です。特に個人情報や顧客データをS3に保存する場合は、誰がどのデータにアクセスできるのかを明確にし、活用とガバナンスを両立させる必要があります。
セブン&アイ・ホールディングスは、グループ横断のロイヤリティプログラムと分析基盤をAWS上に構築しました。事業会社の購買データやアプリ行動データを蓄積するデータレイクをAmazon S3で構築し、Amazon EMRやAmazon Redshiftと組み合わせて分析に活用しています。
これにより、グループ共通IDに紐づく顧客行動の把握、クーポン配信、LTV向上に向けた分析が可能になりました。S3を単なる保管先ではなく、顧客理解とマーケティング施策の基盤として活用した事例です。
出典:AWS 導入事例:株式会社セブン&アイ・ホールディングス
テレビ東京は、13PBにのぼるテレビ映像アーカイブをAmazon S3およびS3 Glacierへ移行しました。従来は物理メディアで管理していた映像資産をクラウドへ移すことで、物理メディアからS3/S3 Glacierへ移行し、新規テープ購入費用の大幅な削減や運用効率化を進めています。
さらに、映像データをクラウド上で扱えるようにしたことで、AIなど先端技術を応用したデータ活用の促進も目指しています。大量の非構造化データをS3に集約し、将来的なAI活用につなげた事例です。
グンゼは、システムごとに分散していたデータの統合・整理に手間がかかるという課題を抱えていました。そこでAmazon S3を活用したデータレイク構築に取り組み、全データを一元的に蓄積・活用できる環境を整備しました。
これにより、横断的な分析と課題解決が可能になりました。S3をデータレイクとして活用し、部門やシステムをまたいだデータ活用を進める事例として参考になります。
出典:グンゼ、Amazon S3を利用してデータレイクを構築 アシストの支援サービスなどを活用
上記でご紹介したデータ利活用事例のように、Amazon S3をデータレイクや分析基盤として活用したい場合にはNTT東日本にご相談ください。自社のデータ量、既存システム、セキュリティ要件に合った構成をご提案します。
小規模な検証であれば、Amazon S3に保存されたCSVやログをAthenaでそのまま分析できます。ただし本格的に活用する場合は、データ形式、文字コード、項目名、欠損値、更新頻度などを整理する必要があります。
特にデータ量が大きくなると、CSVのままでは分析コストや処理時間が増えることがあります。Parquetなどの列指向フォーマットへの変換やパーティション設計を行うことで、分析効率を改善できます。まずは小さく試し、必要に応じて最適化していくアプローチが現実的です。
すべてを内製で行おうとすると、AWS、データベース、情報セキュリティ、分析など幅広い知識が必要になります。ただし、最初から高度な構成を作る必要はありません。
まずはAmazon S3のデータを棚卸しし、Athenaで簡単な集計を行い、QuickSightで可視化するところから始められます。社内に専門人材が少ない場合は、設計・構築・運用を支援できるパートナーに相談することで進めやすくなります。
最初に重要なのはアクセス権限の管理です。新しく作成するS3バケットでは、S3 Block Public Accessが自動的に有効化されるなど、意図しない公開を防ぎやすい初期設定が適用されています。ただし、実運用ではIAM、バケットポリシー、暗号化、アクセスログの確認が必要です。
個人情報や機密情報を扱う場合は、以下の対策を組み合わせましょう。
Amazon S3は強力なストレージサービスですが、データが集まるほど管理責任も大きくなります。分析活用とガバナンスを両立させることが重要です。
本コラムでは、S3が単なるストレージを超えたデータ活用基盤の起点になり得ることを解説してきました。
要点を整理します。
| ポイント | 内容 |
|---|---|
| S3の特徴 | 大量データの保管、イレブンナインの耐久性、AWSサービスとの連携 |
| よくある課題 | データを貯めるだけ、サイロ化、活用担当者の不在 |
| 活用の方向性 | データレイク、CDP、BI、AI活用 |
| 使えるサービス | Glue、Athena、QuickSight、Redshift、SageMaker、Bedrock |
| 成功のカギ | 分析で終わらせず、意思決定・施策実行につなげること |
S3は「データの置き場」ではなく、「データ活用の入口」です。眠っているデータを活かせるかどうかは、これからの使い方次第です。
まずはS3に何が保存されているかを棚卸しする。次に、どの業務課題に使えるかを考える。そして小さな分析から始め、可視化し、施策につなげ、改善を続ける。この流れが、着実な成果への近道です。
S3活用とは、S3の機能を使いこなすことではありません。S3に眠るデータを、業務判断・施策・改善に変えることです。
NTT東日本では、AWSを含むパブリッククラウドの導入・運用を支援しています。Amazon S3の活用方法やAWS環境の構成について『何から検討すればよいかわからない』という段階でも、お気軽にご相談ください。
相談無料!プロが中立的にアドバイスいたします
クラウド・AWS・Azureでお困りの方はお気軽にご相談ください。