
AWSパートナーとは?種類や認定区分、費用、選び方まで詳しく解説
AWSパートナーとは?5つの種類や認定区分、依頼できる支援、費用、活用メリット、選び方を解説。AWSサービスパートナーの認定要件や協業事例も取り上げます。

みなさん、最近生成AIという言葉をよく耳にしませんか?
今回は、2024年3月に発表されたAnthropicの最先端モデルであるClaude3をAmazon Bedrockを利用して、実際に使ってみたのでご紹介します。
目次:
「Amazon Bedrock」は、AWSが提供するフルマネージド型の生成AIサービスです。AnthropicのClaudeをはじめ、複数の基盤モデル(Foundation Model)をAPI経由で利用できるため、自社でAIモデルを構築・運用することなく生成AIアプリケーションを開発できます。本コラムでは、Amazon Bedrock上でClaude 3を利用する方法や各モデルの特徴について紹介します。
「Amazon SageMaker」との違いや料金体系について詳しく知りたい場合は、以下のコラムをご参照ください。
生成AIサービス「Amazon Bedrock」とは?できること・使い方
生成AIアプリケーションの企画開発から活用まで、NTT東日本のクラウドエンジニアがご支援します。まずはお気軽にご相談ください。
「Claude 3」はAnthropic社が開発した生成AI「Claude」の最新モデルです。
主な特徴として以下の能力があります。
今回は提供されている「Claude 3 Haiku」「Claude 3 Sonnet」「Claude 3 Opus」の3つのモデルを使用して応答内容の比較をします。
生成AIアプリケーションの企画開発から活用まで、NTT東日本のクラウドエンジニアがご支援します。まずはお気軽にご相談ください。
それでは、ここから「Amazon Bedrock」で「Claude 3」を利用するための事前準備をしていきます。
はじめに、「Amazon Bedrock」コンソール画面へ移動します。

「Claude 3 Opus」が利用できるリージョンは執筆時点(2024年5月24日)で、米国西部(オレゴン)のみなので、リージョンをオレゴンリージョンに変更します。

左側メニュー「モデルアクセス」を選択すると、モデルアクセス画面が表示されますので「Enable specific models」を選択します。

「Claude 3 Haiku」「Claude 3 Sonnet」「Claude 3 Opus」のチェックボックスを押下し、右下の「Next」ボタンを押下します。

会社名や利用用途などを確認する画面が出るので、それらを埋めて右下の「Next」ボタンを押下します。

入力内容を確認して「Submit」ボタンを押下する。

画面が変わると、アクセスのステータスが「進行中」となりますが、数分待つと、「アクセスが付与されました」に変化します。


これで事前準備は完了です。
生成AIアプリケーションの企画開発から活用まで、NTT東日本のクラウドエンジニアがご支援します。まずはお気軽にご相談ください。
左側メニュー[プレイグラウンド] > [チャット]を選択すると、チャットのプレイグラウンドの画面が表示されますので「モデルを選択」ボタンを押下します。

モデルの選択画面が表示されますので、カテゴリで「Anthropic」、モデルで「Claude 3 Sonnet v1」「Claude 3 Haiku v1」「Claude 3 Opus v1」をそれぞれ選択し、「適用」ボタンを押下します。

チャットの画面が表示されますので、プロンプトに指示や質問を入れて、「続行」ボタンを押下しますと、それに対応して生成が行われます。

生成AIアプリケーションの企画開発から活用まで、NTT東日本のクラウドエンジニアがご支援します。まずはお気軽にご相談ください。
実際に各モデル毎(「Haiku」「Sonnet」「Opus」)に、日本の名物料理とおすすめの観光地を求めるプロンプトの応答内容を比較します。


生成AIアプリケーションの企画開発から活用まで、NTT東日本のクラウドエンジニアがご支援します。まずはお気軽にご相談ください。
Claudeを使用するBedrockを呼び出す際、「ユーザーからの入力」と「AIから返却されるふるまい」というロールの情報を渡すことでより良い出力にしようという以下のようなテクニックがあります。
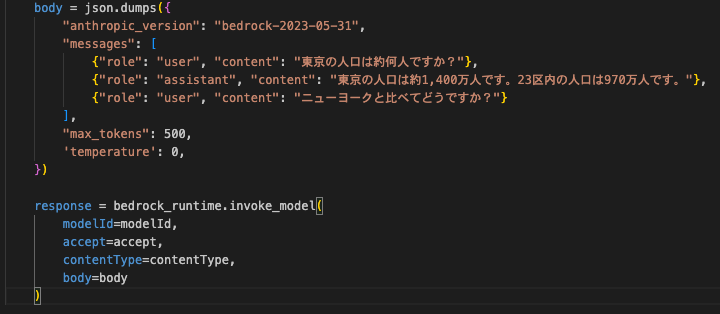
ユーザーからの入力をrole:userとして渡し、AIのふるまいをrole:assistantとして渡している
Claude 3 HaikuやClaude 3.5 Sonnetといったバージョンを使用したBedrockをプログラム(Pythonなど)から呼び出す際にロールの情報を渡すには、「ロールベース形式」と「チャットマークアップ形式」の2つの方法が存在します。
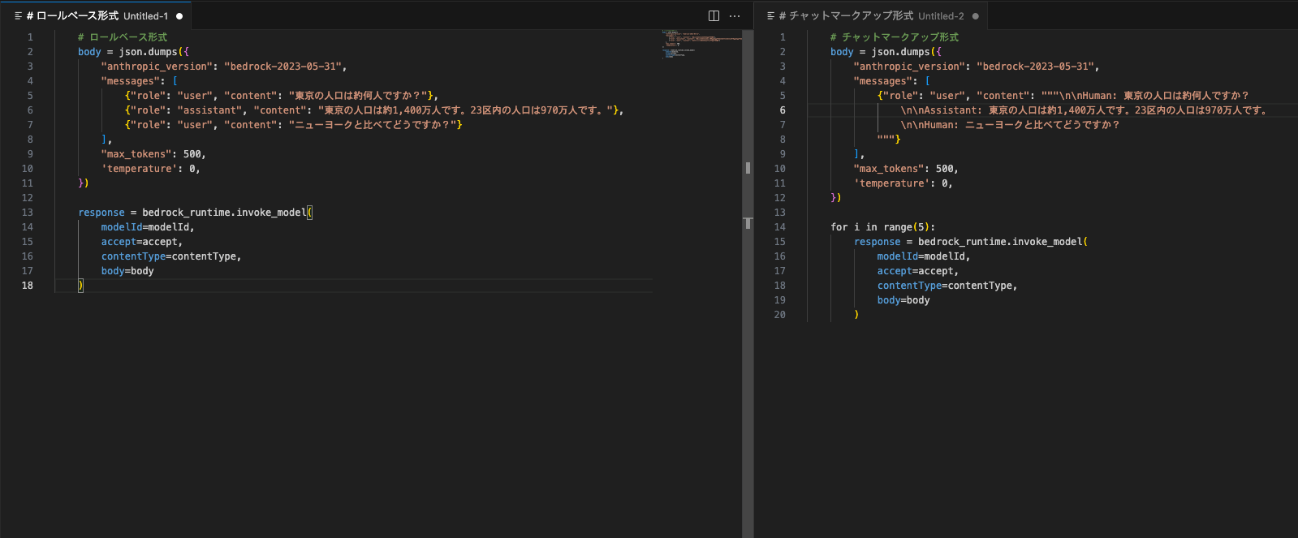
左:ロールベース形式、右:チャットマークアップ形式
AWSのマネジメントコンソールからこの2つの渡し方の違いによって結果が異なるのかClaudeに直接聞いてみると変わらないとの返答とはなりましたが、ご存じの通りLLMは嘘をつくこともあるため、今回いくつかのパターンを作成し、本当に結果は変わらないのか、それとも結果が変わるのか検証していきます。
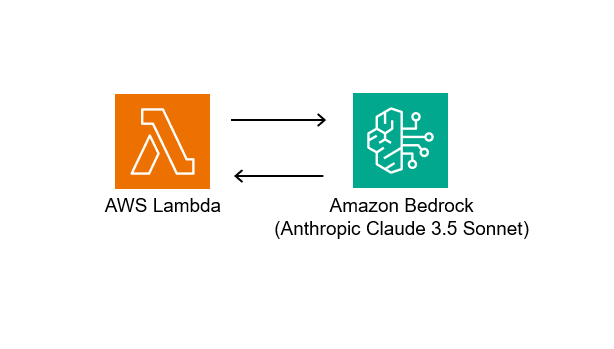
「ロールベース形式」と「チャットマークアップ形式」の呼び出しに対応しているのはPythonなどのプログラムからBedrockから呼び出した場合です。
そのため、上図のようにLambdaからBedrock(Claude 3.5 Sonnet)を呼び出す構成とし、AWSマネジメントコンソールからテストを実施し、CloudWatchに出力されたデータを検証します。
ちなみにLambdaに作成したコードはこちら。(プロンプトのみテストケースごとに更新)
import json
import boto3

def lambda_handler(event, context):

    bedrock_runtime = boto3.client('bedrock-runtime', region_name="ap-northeast-1")
    modelId = 'anthropic.claude-3-5-sonnet-20240620-v1:0'
    accept = 'application/json'
    contentType = 'application/json'

    # ロールベース形式
    body = json.dumps({
        "anthropic_version": "bedrock-2023-05-31",
        "messages": [
            {"role": "user", "content": "東京の人口は約何人ですか?"},
            {"role": "assistant", "content": "東京の人口は約1,400万人です。23区内の人口は970万人です。"},
            {"role": "user", "content": "ニューヨークと比べてどうですか?"}
        ],
        "max_tokens": 500,
        'temperature': 0,
    })

    for i in range(5):
        response = bedrock_runtime.invoke_model(
            modelId=modelId,
            accept=accept,
            contentType=contentType,
            body=body
        )

        response_body = json.loads(response.get('body').read())
        response_text = response_body["content"][0]["text"]
        print(f"role base {i + 1} response_text: {response_text.replace('\n', ' ').replace('\r', '')}")


    # チャットマークアップ形式
    prompt = """\n\nHuman: 東京の人口は約何人ですか?
                \n\nAssistant: 東京の人口は約1,400万人です。23区内の人口は970万人です。
                \n\nHuman: ニューヨークと比べてどうですか?
            """

    body = json.dumps({
        "anthropic_version": "bedrock-2023-05-31",
        "messages": [
            {"role": "user", "content": prompt}
        ],
        "max_tokens": 500,
        'temperature': 0,
    })

    for i in range(5):
        response = bedrock_runtime.invoke_model(
            modelId=modelId,
            accept=accept,
            contentType=contentType,
            body=body
        )

        response_body = json.loads(response.get('body').read())
        response_text = response_body["content"][0]["text"]
        print(f"chat mark up base {i + 1} response_text: {response_text.replace('\n', ' ').replace('\r', '')}")

    return True
LLMは同じプロンプトでも違う内容を出力することもあるので念のため上記コードではそれぞれ5回ループしていますが、今回の検証では結果が変わらなかったため、次章以降では1回の結果のみ掲載します。
まずは東京都とニューヨークの人口比較の例です。
Claudeに例題を考えてもらいました。
ロールベース形式でプロンプト部分を書くと以下のようになります。
body = json.dumps({
    "anthropic_version": "bedrock-2023-05-31",
    "messages": [
        {"role": "user", "content": "東京の人口は約何人ですか?"},
        {"role": "assistant", "content": "東京の人口は約1,400万人です。23区内の人口は970万人です。"},
        {"role": "user", "content": "ニューヨークと比べてどうですか?"}
    ],
    "max_tokens": 500,
    'temperature': 0,
})
出力結果は以下となりました。
| 【ロールベース形式】 | 【チャットマークアップ形式】 |
|---|---|
| ニューヨーク市の人口は約860万人ですので、東京23区の人口(970万人)と比較すると、東京の方がやや多いです。 ただし、ニューヨーク大都市圏(トライステート地域)の人口は約2,000万人ともいわれています。この地域全体で比較すると、ニューヨークの方が人口は多いといえます。 東京という一つの政令指定都市の人口と、ニューヨークを含む大都市圏全体の人口比較は難しい面もありますが、大まかにはこのような関係です。東京は世界でも有数の巨大都市で、ニューヨークと並ぶほどの人口規模を持っています。 | 東京とニューヨークの人口を比較すると以下のようになります。 - 東京23区の人口は約970万人 - ニューヨーク市の人口は約860万人 つまり、東京23区の方が若干人口が多いです。ただし、郊外も含めた大都市圏全体で比較すると、 - 東京都市圏の人口は約3700万人 - ニューヨーク都市圏の人口は約2000万人 となり、東京の方がかなり人口が多いことがわかります。東京は世界最大の都市圏を形成していると言えます。 |
「東京のほうが多い」情報はどちらも出力していますが、一方にだけ出力されている情報もあるなど回答から受ける印象は違うことが分かります。
6-2-1では、事実に基づいて回答を作成する内容でした。
ここでは前提条件を与え、それに基づきおすすめを挙げさせる(考えさせる)内容です。
こちらもClaudeに考えてもらいました。
ロールベース形式でプロンプト部分を書くと以下の内容です。
body = json.dumps({
    "anthropic_version": "bedrock-2023-05-31",
    "messages": [
        {"role": "user", "content": "晴れの日と雨の日で異なるおすすめの活動を教えてください。"},
        {"role": "assistant", "content": "晴れの日のおすすめ活動:\n1. ピクニック\n2. ハイキング\n3. 野外スポーツ\n\n雨の日のおすすめ活動:\n1. 美術館巡り\n2. 映画鑑賞\n3. 室内でのボードゲーム"},
        {"role": "user", "content": "今日は曇りです。曇りの日のおすすめ活動を3つ挙げてください。"}
    ],
    "max_tokens": 500,
    'temperature': 0,
})
出力結果は以下となりました。
| 【ロールベース形式】 | 【チャットマークアップ形式】 |
|---|---|
|
今日は曇りの日ですね。曇りの日のおすすめ活動を3つ挙げます。
こうした屋内のアクティビティが曇りの日には向いていると思います。 |
曇りの日のおすすめ活動3つを挙げます。
|
どちらも1つめのショッピングは同じですが、その他は違っています。
同じ形式の場合、同じ出力なるため、形式によって回答が変わっていることが分かります。
これまでは一般的な内容でしたが、業務で活用できそうなケースを試します。
ある文章から必要な情報を抜き出し、指定されたjson形式にして返すというものです。
ロールベース形式でプロンプト部分を書くと以下の内容です。
body = json.dumps({
    "anthropic_version": "bedrock-2023-05-31",
    "messages": [
        {"role": "user", "content": """以下の<text></text>タグ内の文章から必要な要件を抜き出してください。
            回答は<example></example>タグ内の例に従ってください。
<text>NTT東日本、営業部の森と申します。2024年11月1日に打ち合わせをお願いします。</text>
<example>
            {
                "company": $company,
                "department": $department,
                "name": $name,
                "requirement": $requirement
            }
</example>
            """},
        {"role": "assistant", "content": "{"}
    ],
    "max_tokens": 500,
    'temperature': 0,
})
このassistantロールのcontentに”{“が入っているのはこの続きから書き出してねとClaudeに伝えるものであり、出力形式を指定したい場合によく使われます。
出力結果は以下となりました。
| 【ロールベース形式】 |
|---|
|
| 【チャットマークアップ形式】 |
|
どちらも必要な情報を抜き出すことはできていますが、チャットマークアップ形式の場合、jsonの前にテキストが入ってしまっています。
一方、ロールベース形式では、プロンプトに既に指定してある”{“の続きから出力されており、期待通りの動作となりました。
これまでの結果を簡単にまとめます。
一般的な内容であればロールベース形式もチャットマークアップ形式も大きな差はない(あくまで表現の違い程度)と言えますが、業務で使うような場面だとロールベース形式のほうがプロンプトに忠実で優れていると感じました。
このことから新規にアプリケーションを構築するのであればロールベース形式を用いることを前提に設計を行うことをおすすめします。
しかし、プロンプトを動的に作るようなシステムの場合、チャットマークアップ形式は1つの文字列を作ればよく工数が少なくなるという利点もあります。
また、Claude 2以前のモデルからClaude 3に移行する場合も工数が少なくなることが予想されます。
これらを考慮し、どちらの形式がいいか検証したうえで構築していくとよいでしょう。
本コラムでは、Amazon Bedrock上でClaude 3(Haiku、Sonnet、Opus)を利用する方法と、それぞれのモデルの特徴を確認しました。また、ロールベース形式とチャットマークアップ形式の出力結果を比較したところ、一般的な会話では大きな差はないものの、業務で利用する情報抽出や出力制御ではロールベース形式の方が安定した結果を得られることが分かりました。
Amazon Bedrockは複数の生成AIモデルを手軽に利用できるサービスです。生成AIを活用したシステム開発を検討する際は、用途に応じたモデル選定に加え、プロンプト設計や入力形式についてもあわせて検証することをおすすめします。
NTT東日本では3,000名以上のAWSやMicrosoft Azureの認定資格者が過去の経験や知見をもとに直接お客さまの対応をします!
生成AIアプリケーションの企画開発から活用まで、NTT東日本のクラウドエンジニアがご支援します。まずはお気軽にご相談ください。
NTT東日本なら貴社のクラウド導入設計から
ネットワーク環境構築・セキュリティ・運用まで
”ワンストップ支援”が可能です!
特に以下に当てはまる方はお気軽に
ご相談ください。
クラウドを熟知するプロが、クラウド導入におけるお客さまのLAN 環境や接続ネットワーク、
クラウドサービスまでトータルにお客さまのお悩みや課題の解決をサポートします。
相談無料!プロが中立的にアドバイスいたします
クラウド・AWS・Azureでお困りの方はお気軽にご相談ください。